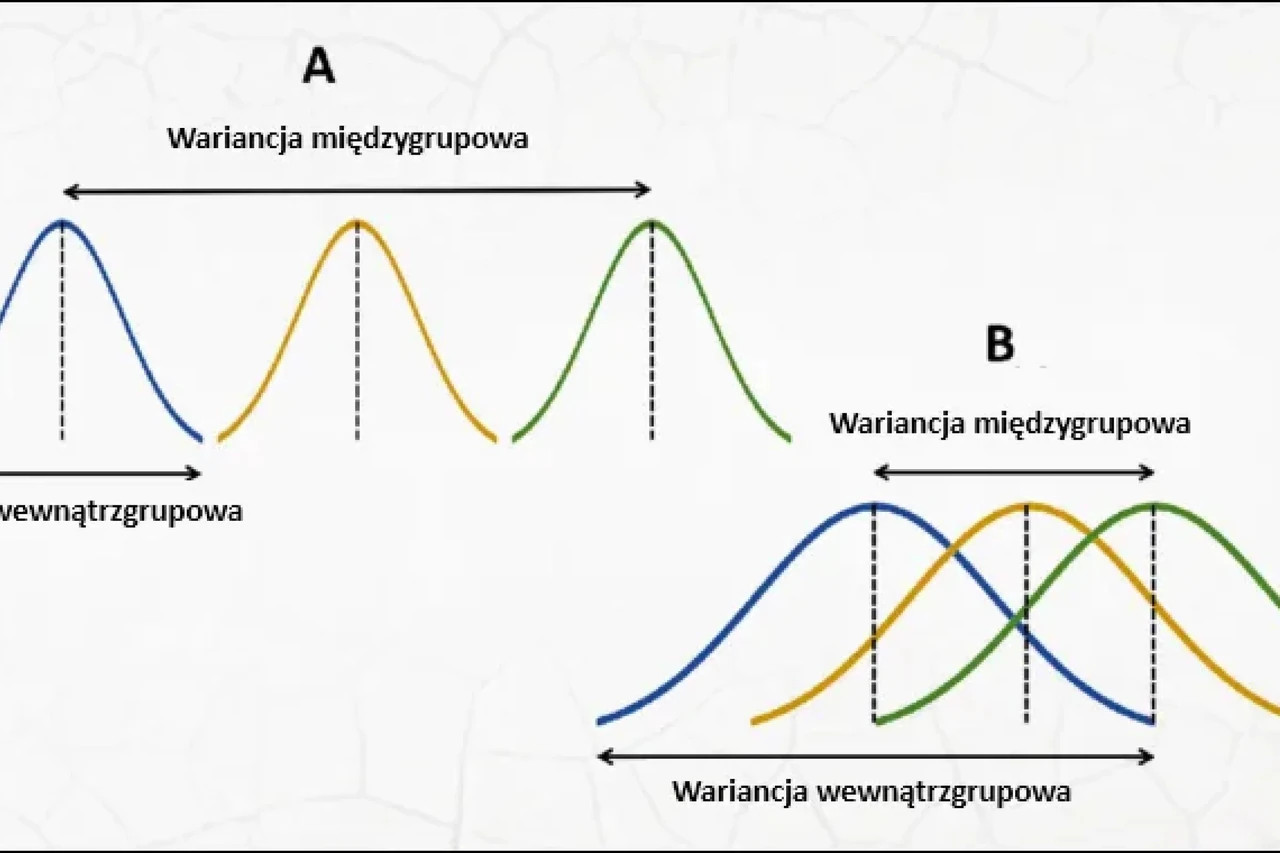
Дисперсия — это статистическая мера, которая точно количественно определяет рассеяние значений вокруг среднего, а её формула лежит в основе многих видов анализа — от простых наборов данных до сложных вероятностных моделей. Важно различать дисперсию генеральной совокупности, где деление идёт на полную численность N, и дисперсию выборки, где применяется коррекция с делением на n−1, чтобы получить несмещённую оценку для более широкой совокупности.
Для продвинутых пользователей дисперсия случайной величины выражается как математическое ожидание квадрата отклонения от математического ожидания. Это позволяет моделировать неопределённость в физике, экономике и биологии. Практическое освоение этих формул и их нюансов напрямую помогает делать более точные выводы в исследованиях, бизнесе и принятии решений в условиях изменчивости окружающего мира.
Основы дисперсии — что на самом деле измеряет эта статистика
Дисперсия — это не просто число, а квинтэссенция того, насколько данные «отклоняются» от своего центра. Представьте стрельбу по мишени: среднее показывает, где сосредоточена точность, а дисперсия раскрывает, ложатся ли стрелы плотно вокруг центра или разлетаются по всей мишени. Чем больше дисперсия, тем сильнее хаос и тем менее предсказуем результат.
На практике дисперсия возникает из простого механизма: берём каждое значение, вычитаем из него среднее, возводим разность в квадрат (чтобы избавиться от знака и сильнее наказать большие отклонения), суммируем и делим на соответствующее число. Квадраты приводят к тому, что один экстремальный результат может существенно завысить итоговое значение — это и преимущество (повышенная чувствительность к аномалиям), и вызов (чувствительность к выбросам).
Дисперсия всегда принимает неотрицательные значения, а ноль означает абсолютную однородность всех наблюдений — все данные идентичны.
Формула дисперсии генеральной совокупности — для полных наборов данных
Когда мы располагаем данными всей генеральной совокупности, используем формулу:
σ² = (1/N) × Σ (xᵢ − μ)²
где σ² — дисперсия генеральной совокупности, N — число всех элементов, xᵢ — отдельные значения, а μ — среднее генеральной совокупности (истинное, известное).
Расчёты выполняем поэтапно. Сначала определяем среднее. Затем для каждого значения вычисляем отклонение, возводим в квадрат и суммируем. В конце делим на N. Это самая простая и часто встречающаяся в школьных материалах версия, идеальная, когда мы действительно знаем всю группу — например, все результаты экзамена в одном классе из 30 человек.
Пример с небольшим набором: данные 5, 7, 9. Среднее равно 7. Отклонения: −2, 0, +2. Квадраты: 4, 0, 4. Сумма квадратов = 8. Дисперсия генеральной совокупности = 8/3 ≈ 2,67. Данные умеренно рассеяны вокруг центра.
Коррекция Бесселя и дисперсия выборки — почему делим на n−1
В большинстве реальных ситуаций мы не знаем всю генеральную совокупность. У нас есть только выборка — 50 случайно отобранных клиентов, 200 измерений температуры, 8 результатов теста. Если бы мы тогда поделили на n (число в выборке), то систематически занижали бы истинную дисперсию совокупности. Решением является коррекция Бесселя — делим сумму квадратов отклонений на n−1.
Почему именно n−1? Когда мы оцениваем среднее по выборке, теряем одну степень свободы. Среднее выборки уже «подогнано» под данные, поэтому остальные отклонения немного меньше, чем в истинной совокупности. Деля на меньшее число (n−1), мы «возвращаем» эту потерянную информацию и получаем несмещённую оценку.
| Аспект | Дисперсия генеральной совокупности (σ²) | Дисперсия выборки (s²) | Когда применять |
|---|---|---|---|
| Делитель | N (вся совокупность) | n−1 (коррекция Бесселя) | Всегда при оценке по выборке |
| Смещение | Отсутствует (при известном μ) | Несмещённая оценка | Научные исследования, бизнес, опросы |
| Типичный контекст | Весь класс, все станки на заводе | Случайная группа респондентов, лабораторные пробы | Практическая статистика |
Разница между делением на n и n−1 может быть удивительно большой при малых выборках — при n=8 она может достигать даже 14% значения.
Расчётная формула — хитрый способ избежать ошибок
Существует эквивалентная, часто более удобная форма формулы, которая не требует предварительного вычисления среднего для каждого значения:
σ² = (1/N) × [Σ xᵢ² − (1/N) × (Σ xᵢ)²]
Для выборки заменяем N на n−1 во внешнем делителе. Этот вариант минимизирует количество промежуточных операций и снижает риск ошибок округления при больших наборах или ручных расчётах. В программировании и электронных таблицах именно эта форма часто быстрее и численно более стабильна.
Дисперсия в мире вероятностей — для случайных величин
При переходе к случайным величинам определение становится элегантным и универсальным. Дисперсия случайной величины X равна:
Var(X) = E[(X − μ)²]
или эквивалентно E[X²] − μ², где μ = E[X] — математическое ожидание. Эта форма открывает двери в теорию вероятностей: дисперсия биномиального распределения равна np(1−p), распределения Пуассона — λ, а нормального распределения — σ². Благодаря этому мы можем точно предсказать, насколько будут рассеиваться результаты эксперимента, ещё до того, как проведём измерения.
Практический расчёт дисперсии — от руки до электронных таблиц
Возьмём реальный пример — результаты теста по математике у восьми учеников: 72, 85, 68, 91, 77, 82, 69, 88. Среднее составляет ровно 79. Сумма квадратов отклонений равна 544. Дисперсия генеральной совокупности = 544/8 = 68. Дисперсия выборки (с коррекцией) = 544/7 ≈ 77,71.
В Excel или Google Sheets используем функции VAR.P (или VAR.POP) для совокупности и VAR.S (или VAR.SAMPLE) для выборки. В Python с библиотекой NumPy: np.var(data, ddof=0) для совокупности и ddof=1 для выборки. В R аналогично var() по умолчанию применяет коррекцию Бесселя. Эти инструменты экономят время и устраняют арифметические ошибки при сотнях или тысячах записей.
Применение дисперсии — от фондового рынка до контроля качества
В финансах дисперсия (или её корень — стандартное отклонение) представляет собой классическую меру риска. Портфель с низкой дисперсией доходности более стабилен, что для инвестора означает меньшие шансы на болезненные потери в краткосрочной перспективе. Теория Марковица 1950-х годов именно на дисперсии основала концепцию диверсификации.
В контроле качества дисперсия измеряет повторяемость производственного процесса. Низкая дисперсия диаметра винтов означает, что почти все изделия укладываются в допуск — меньше рекламаций, выше удовлетворённость клиентов. В медицине дисперсия реакции на препарат показывает, действует ли терапия одинаково у разных пациентов или требует персонализации.
В спорте низкая дисперсия результатов спортсмена от матча к матчу сигнализирует о надёжности — тренеры предпочитают стабильного игрока «гению одной ночи».
Дисперсия против других мер рассеяния — когда какая выигрывает
Дисперсия — не единственная мера изменчивости. Размах (max − min) прост, но чувствителен к отдельным выбросам. Стандартное отклонение (корень из дисперсии) имеет то преимущество, что выражается в тех же единицах, что и данные — его легче интерпретировать. Среднее абсолютное отклонение (MAD) более устойчиво к выбросам, но математически менее удобно для дальнейших расчётов.
| Мера | Преимущества | Недостатки | Лучшее применение |
|---|---|---|---|
| Дисперсия | Основа многих статистических моделей, аддитивна для независимых переменных | Квадратные единицы, чувствительна к выбросам | Дисперсионный анализ (ANOVA), инвестиционные портфели |
| Стандартное отклонение | Те же единицы, что и данные, лёгкая интерпретация | Всё ещё подвержено крайним значениям | Отчёты, контроль качества, сравнения |
| MAD | Устойчиво к выбросам | Сложнее в дальнейших расчётах | Загрязнённые выбросами данные |
Ловушки и ошибки, которых стоит избегать при анализе дисперсии
Самая частая ошибка — автоматическое деление на n вместо n−1 при работе с выборкой, особенно при малых группах: разница может изменить выводы о статистической значимости. Вторая классическая проблема — игнорирование единиц измерения. Дисперсия выражается в квадратных единицах (например, см²), поэтому для общения с нетехнической аудиторией лучше приводить стандартное отклонение.
Третья ловушка — чрезмерная чувствительность к выбросам. Один ошибочный замер может в несколько раз завысить дисперсию. В таких случаях стоит рассмотреть робастные оценки или сначала очистить данные. Наконец — интерпретация без контекста. Дисперсия 100 для результатов теста по шкале 0–100 означает совсем другое, чем дисперсия 100 для цен квартир в Москве.
Продвинутые свойства дисперсии — что стоит знать экспертам
Дисперсия обладает несколькими элегантными математическими свойствами, которые делают её такой полезной. Во-первых, Var(aX) = a² × Var(X) — масштабирование данных квадратично масштабирует дисперсию. Во-вторых, добавление константы не меняет дисперсию: Var(X + c) = Var(X). В-третьих, для независимых переменных дисперсии складываются: Var(X + Y) = Var(X) + Var(Y). Именно благодаря этой аддитивности возможно разделение источников изменчивости в моделях ANOVA или в анализе погрешности измерений.
В многомерном пространстве появляется матрица дисперсий-ковариаций, которая описывает не только рассеяние каждой переменной, но и их взаимосвязи. В машинном обучении дисперсия ошибок модели — один из трёх компонентов ошибки обобщения (наряду со смещением и неустранимым шумом).
Дисперсия в эпоху больших данных — современные вызовы
В сегодняшних наборах, насчитывающих миллионы записей, классические формулы по-прежнему работают, но появляются новые нюансы. При очень больших выборках разница между делением на n и n−1 становится пренебрежимо малой — тогда можно спокойно применять версию для совокупности. Одновременно растёт значение робастных методов оценки дисперсии, когда данные содержат шум или автоматически генерируемые выбросы.
Современные инструменты — от библиотек Python (pandas, numpy, scipy) через R до специализированных аналитических платформ — реализуют обе версии формулы и автоматически подбирают коррекцию в зависимости от контекста. Ключом остаётся понимание, что именно мы измеряем и почему выбираем конкретный делитель. Без этого осознания даже самый быстрый алгоритм вернёт число, которое может ввести в заблуждение при принятии решений.
Освоение формулы дисперсии — это не только арифметический навык, но и компетенция, которая позволяет читать мир, полный изменчивости, с большей уверенностью и точностью.


